10 esempi pratici
26Esempio 8 · Analisi di dati
Due agenti rispondono alle domande del titolare di un negozio sui dati di vendita. La regola chiave: i conti li fa uno strumento scritto in Python, il modello decide cosa calcolare e spiega. Con la variante text-to-SQL e i suoi rischi.
Il titolare di un piccolo negozio di alimentari ha un file con tutte le vendite dell'estate, esportato dalla cassa. Vorrebbe sapere cose semplici: quale reparto ha incassato di più, se agosto è andato meglio di luglio, quanto vende online. Non sa usare le tabelle pivot e non ha tempo di impararle. Lo stesso problema lo hanno un'associazione con il foglio delle quote, un ufficio con le presenze, un'officina con gli interventi.
La tentazione è incollare il file in una chat e fare la domanda. In questo esempio costruisci invece la soluzione giusta: i conti li fa il codice, non il modello.
- Problema
- Rispondere a domande in linguaggio naturale su un file di vendite, con numeri esatti e un report comprensibile per chi non è esperto.
- La squadra (agenti)
- Analista (sceglie e chiede i calcoli allo strumento) e redattore (scrive il report per il titolare).
- Strumenti
- Uno strumento proprio,
riepilogo_vendite, scritto con@toolin Python puro, usando solo la libreria standardcsv. - Chiavi e costi
- Nessuna chiave esterna oltre a quella del modello; con Ollama è tutto gratuito e i dati restano sul tuo computer. Lo strumento non costa nulla: gira in locale.
- Cosa impari di nuovo
- Leggere un file CSV da Python, scrivere uno strumento che fa calcoli esatti, provarlo da solo senza modello, e i rischi di far scrivere query SQL a un modello.
Perché è tra i più usati#
L'analisi di dati è all'8° posto nella classifica del corso, con 29,6 punti. I segnali principali, raccolti il 15 settembre 2026:
- Sondaggi. Nel sondaggio di LangChain State of Agent Engineering (1.340 risposte, fine 2025) «ricerca e analisi dei dati» è il secondo uso principale degli agenti, scelto dal 24,4% dei partecipanti. Tra gli esempi di agenti interni i partecipanti citano proprio il Text-to-SQL: Tecnica in cui un modello traduce una domanda scritta in italiano in una query SQL, che poi un programma esegue sul database. glossario.
- Materiale ufficiale. La guida della documentazione di CrewAI per valutare i casi d'uso nomina l'analisi esplorativa dei dati; il secondo corso di DeepLearning.AI su CrewAI ha una lezione sull'analisi dei dati dell'assistenza clienti.
- Progetti su GitHub. 193 repository con "crewai data analysis" nel nome o nella descrizione; tra i progetti che sembrano applicazioni vere, il 7,7% riguarda analisi di dati e SQL.
Il principio: il modello sceglie, il codice calcola#
Nel capitolo 2 hai visto che un LLM: Large Language Model, grande modello linguistico: un programma addestrato su enormi quantità di testo che, data una frase, prevede le parole che seguono. È il motore di ChatGPT, Claude, Gemini. glossario prevede le parole successive. Quando scrive «1.715,20 euro» non ha fatto una somma: ha scritto un numero che sembra giusto in quel punto. Con numeri piccoli spesso ci azzecca, con una tabella intera no. Ed è l'errore peggiore, perché un numero sbagliato scritto bene non si nota: è un'Allucinazione: Quando un modello scrive con sicurezza una cosa falsa o inventata. Succede perché il modello genera testo plausibile, non verifica fatti. glossario travestita da dato.
La soluzione è dividere il lavoro come in un ufficio. Il titolare fa la domanda. L'analista (un agente) capisce che servono «incasso per categoria» e «incasso per mese», e li chiede alla calcolatrice. La calcolatrice (uno Strumento (tool): Una funzione che l'agente può chiamare per agire fuori dal modello: cercare sul web, leggere un file, interrogare un database, inviare una email. glossario scritto in Python) legge il file e restituisce i totali esatti. Il redattore (un altro agente) li trasforma in un testo chiaro. Nessun numero nasce nel modello.
I dati stanno in un file CSV: File di tabella in testo semplice: una riga per record, valori separati da virgole. Si apre con Excel o Fogli Google. glossario: il formato più semplice per una tabella, una riga per ogni vendita, valori separati da virgole. Lo esportano quasi tutti i gestionali e si apre con Excel o Fogli Google.
Lo schema#
Preparazione#
Crea una cartella, per esempio analisi-vendite. Dentro metti il file .env. Questo esempio non ha bisogno di chiavi oltre a quella del modello, quindi puoi usare un modello gratuito sul tuo computer (capitolo 7):
MODEL=ollama/qwen2.5:7b
CREWAI_DISABLE_TELEMETRY=true
In alternativa usa MODEL=openai/gpt-4.1-mini con OPENAI_API_KEY=...: più avanti vedi perché, per questo esempio, un modello più capace fa differenza.
Scarica nella stessa cartella il file vendite.csv. I dati sono inventati: 125 vendite di un negozio di alimentari immaginario, dal 1° giugno al 31 agosto 2026, generate da un programma. Le prime righe sono queste:
data,prodotto,categoria,canale,quantita,prezzo_unitario
2026-06-01,Passata di pomodoro 700 g,Conserve,online,4,2.20
2026-06-02,Succo di mela 1 l,Bevande,online,3,3.60
2026-06-03,Passata di pomodoro 700 g,Conserve,negozio,6,2.20
La prima riga contiene i nomi delle colonne. Nota che i decimali usano il punto, come si fa nei file per i programmi.
Se esporti un CSV da Excel in italiano, spesso il separatore è il punto e virgola e i decimali hanno la virgola. Aprendo il file con un editor di testo lo vedi subito. Lo strumento di questo esempio si aspetta virgole e punti: per un file diverso vanno cambiate due righe (lo vedi negli esercizi).
Il codice, pezzo per pezzo#
1. Dove sta il file#
# Il file dei dati sta nella stessa cartella dello script.
FILE_DATI = Path(__file__).parent / "vendite.csv"
RAGGRUPPAMENTI = ("categoria", "prodotto", "canale", "mese")
Path(__file__).parent è la cartella in cui si trova lo script: così il file viene trovato anche se lanci il comando da un'altra cartella. RAGGRUPPAMENTI elenca i modi ammessi di raggruppare i dati; servirà per controllare le richieste del modello.
2. Lo strumento che fa i conti#
Questa è la parte più importante. È una Funzione: Un blocco di codice con un nome che fa un lavoro e restituisce un risultato. Si definisce con def e si chiama con le parentesi: somma(2, 3). glossario Python normale, trasformata in strumento dal Decoratore: Una riga che inizia con @ sopra una funzione e le aggiunge un comportamento. In CrewAI: @agent, @task, @start, @listen. glossario @tool (capitolo 12):
@tool("Riepilogo vendite")
def riepilogo_vendite(raggruppa_per: str, mese: str = "tutti") -> str:
    """Calcola incasso e pezzi venduti dal file vendite.csv, raggruppati per
    'categoria', 'prodotto', 'canale' oppure 'mese'. Il parametro mese filtra
    un solo mese nel formato AAAA-MM (per esempio 2026-07) oppure 'tutti'."""
    # Controllo gli ingressi: se il modello chiede una colonna che non esiste, glielo dico.
    if raggruppa_per not in RAGGRUPPAMENTI:
        return f"Errore: raggruppa_per deve essere uno tra {', '.join(RAGGRUPPAMENTI)}."
    if not FILE_DATI.exists():
        return f"Errore: non trovo il file {FILE_DATI}."
    incasso = defaultdict(float)  # nome del gruppo -> euro incassati
    pezzi = defaultdict(int)      # nome del gruppo -> pezzi venduti
    with FILE_DATI.open(encoding="utf-8", newline="") as f:
        for riga in csv.DictReader(f):  # ogni riga diventa un dizionario colonna -> valore
            mese_riga = riga["data"][:7]  # "2026-07-15" -> "2026-07"
            if mese != "tutti" and mese_riga != mese:
                continue
            chiave = mese_riga if raggruppa_per == "mese" else riga[raggruppa_per]
            quantita = int(riga["quantita"])
            pezzi[chiave] += quantita
            incasso[chiave] += quantita * float(riga["prezzo_unitario"])
    if not incasso:
        return f"Nessuna vendita trovata per il mese {mese}."
    righe = [f"Raggruppamento: {raggruppa_per} | mese: {mese}"]
    for chiave in sorted(incasso, key=incasso.get, reverse=True):  # dal più alto al più basso
        righe.append(f"- {chiave}: incasso {incasso[chiave]:.2f} euro, {pezzi[chiave]} pezzi")
    righe.append(f"TOTALE: incasso {sum(incasso.values()):.2f} euro, {sum(pezzi.values())} pezzi")
    return "\n".join(righe)
Leggilo con calma, dall'alto:
- La docstring (il testo tra le triple virgolette) è la descrizione che l'agente legge per capire quando e come usare lo strumento. Dice quali valori sono ammessi e il formato del mese. Senza docstring CrewAI rifiuta lo strumento.
- I parametri con il tipo (
raggruppa_per: str) diventano i campi che il modello deve compilare quando chiama lo strumento.meseha un valore predefinito, quindi è facoltativo. - Il controllo iniziale non si fida del modello: se chiede di raggruppare per una colonna inesistente, riceve un messaggio d'errore chiaro invece di un crash. Vedrai più avanti che succede davvero.
csv.DictReaderlegge il file una riga alla volta e trasforma ogni riga in un Dizionario: Una raccolta di coppie nome → valore tra parentesi graffe:{"citta": "Arezzo"}. glossario, per esempio{"categoria": "Dolci", "quantita": "2", ...}. I valori arrivano come testo:int()efloat()li trasformano in numeri.defaultdictè un dizionario che parte da zero per ogni nuovo gruppo: così basta scrivere+=senza controllare se il gruppo esiste già.- Il risultato è testo semplice, ordinato dal gruppo che incassa di più, con il totale in fondo. Il modello lo legge facilmente e non deve fare nessun calcolo.
Niente pandas o altre librerie: csv fa parte di Python, quindi non c'è nulla da installare oltre a CrewAI.
3. Prova lo strumento da solo, prima del modello#
Uno strumento che sbaglia i conti rovina tutto il resto, e nessun agente se ne accorgerebbe. Per questo lo script ha una modalità di prova che chiama lo strumento direttamente, senza modello e senza costi:
    if "--prova" in sys.argv:
        # Prova lo strumento da solo, senza modello e senza costi.
        print(riepilogo_vendite.run(raggruppa_per="categoria"))
        print(riepilogo_vendite.run(raggruppa_per="canale", mese="2026-08"))
        print(riepilogo_vendite.run(raggruppa_per="colore"))
        raise SystemExit
sys.argv è la lista delle parole scritte dopo il nome dello script nel terminale. Si lancia così:
uv run --env-file .env analisi_vendite.py --provaQuesto è l'output reale ottenuto con il file vendite.csv del corso e CrewAI 1.15.21:
Raggruppamento: categoria | mese: tutti
- Dolci: incasso 465.50 euro, 56 pezzi
- Conserve: incasso 464.70 euro, 156 pezzi
- Bevande: incasso 312.20 euro, 60 pezzi
- Pasta e riso: incasso 269.80 euro, 83 pezzi
- Olio: incasso 203.00 euro, 14 pezzi
TOTALE: incasso 1715.20 euro, 369 pezzi
Raggruppamento: canale | mese: 2026-08
- negozio: incasso 353.40 euro, 73 pezzi
- online: incasso 246.30 euro, 53 pezzi
TOTALE: incasso 599.70 euro, 126 pezzi
Errore: raggruppa_per deve essere uno tra categoria, prodotto, canale, mese.
Abbiamo controllato il totale con un calcolo indipendente sulle 125 righe: 1.715,20 euro e 369 pezzi, identico. Nota due cose. Dolci e Conserve sono separati da 80 centesimi: un modello che «stima» li scambierebbe facilmente. E con una richiesta sbagliata («colore») lo strumento risponde con un errore spiegato.
Se vedi gli stessi numeri, lo strumento funziona e il file è quello giusto. Solo adesso ha senso collegarlo a un agente.
4. I due agenti#
analista = Agent(
    role="Analista dei dati di vendita di un piccolo negozio",
    goal="Rispondere alle domande del titolare usando solo numeri calcolati dallo strumento Riepilogo vendite",
    backstory=(
        "Lavori da anni con negozi di quartiere. Non fai mai i conti a mente: "
        "per ogni numero chiami lo strumento e riporti il risultato esatto. "
        "Se un dato non è nel file, lo dici chiaramente."
    ),
    tools=[riepilogo_vendite],
    llm=MODELLO,
    max_iter=8,  # bastano pochi giri: al massimo qualche chiamata allo strumento
    verbose=True,
)
L'analista è l'unico con lo strumento. La backstory ripete la regola chiave: niente conti a mente. max_iter: Numero massimo di giri di ragionamento che un agente può fare su un task prima di dare la risposta migliore che ha. In CrewAI 1.15 il valore predefinito è 25. glossario a 8 limita i giri di ragionamento: se il modello si incastra a chiamare lo strumento nel modo sbagliato, dopo 8 tentativi consegna la risposta migliore che ha invece di consumare Token: Il pezzetto di testo con cui ragiona un modello: una parola corta, un pezzo di parola o un segno di punteggiatura. Secondo le stime di OpenAI, in inglese un token vale in media circa ¾ di parola. I servizi a pagamento contano (e fanno pagare) i token. glossario all'infinito.
Il redattore non ha strumenti: riceve i numeri dell'analista e scrive. Perché due agenti e non uno? Perché hanno compiti davvero diversi: uno lavora con lo strumento e deve essere preciso, l'altro scrive per una persona che non conosce i dati. La skill ufficiale design-agent suggerisce di separare gli agenti proprio quando cambiano strumenti e modo di esprimersi.
5. I due task#
analisi = Task(
    description=(
        "Il titolare del negozio chiede: \"{domanda}\"\n"
        "Decidi quali calcoli servono e chiedili allo strumento Riepilogo vendite. "
        "Puoi chiamarlo più volte, per esempio una volta per categoria e una per mese. "
        "Non calcolare nulla a mente e non fare stime."
    ),
    expected_output=(
        "Un elenco puntato in italiano: per ogni calcolo, i parametri usati e i numeri "
        "restituiti dallo strumento, copiati esattamente. Chiudi con una frase che risponde alla domanda."
    ),
    agent=analista,
)
La domanda arriva dal Segnaposto {…}: Una parola tra graffe, come {citta}, dentro i testi di agenti e task. Al kickoff(inputs={...}) viene sostituita con il valore vero. glossario {domanda}, così puoi farne altre senza toccare il codice. Il risultato atteso chiede di riportare anche i parametri usati: se un numero è strano, puoi controllare quale calcolo l'ha prodotto. Il task del redattore chiede un report di massimo 200 parole «senza numeri che non compaiano nell'analisi» e lo salva con output_file="report_vendite.md".
Il codice completo#
Salva questo file come analisi_vendite.py nella cartella con .env e vendite.csv.
# /// script
# requires-python = ">=3.10,<3.14"
# dependencies = ["crewai[tools]==1.15.21"]
# ///
"""Risponde a una domanda sulle vendite di un negozio: i conti li fa Python, gli agenti scelgono e spiegano."""
import csv
import os
import sys
from collections import defaultdict
from pathlib import Path

from crewai import Agent, Crew, Process, Task
from crewai.tools import tool

# Il modello si sceglie nel file .env (capitolo 7). Se MODEL manca, si usa quello scritto qui.
MODELLO = os.getenv("MODEL", "openai/gpt-4.1-mini")

# Il file dei dati sta nella stessa cartella dello script.
FILE_DATI = Path(__file__).parent / "vendite.csv"
RAGGRUPPAMENTI = ("categoria", "prodotto", "canale", "mese")


@tool("Riepilogo vendite")
def riepilogo_vendite(raggruppa_per: str, mese: str = "tutti") -> str:
    """Calcola incasso e pezzi venduti dal file vendite.csv, raggruppati per
    'categoria', 'prodotto', 'canale' oppure 'mese'. Il parametro mese filtra
    un solo mese nel formato AAAA-MM (per esempio 2026-07) oppure 'tutti'."""
    # Controllo gli ingressi: se il modello chiede una colonna che non esiste, glielo dico.
    if raggruppa_per not in RAGGRUPPAMENTI:
        return f"Errore: raggruppa_per deve essere uno tra {', '.join(RAGGRUPPAMENTI)}."
    if not FILE_DATI.exists():
        return f"Errore: non trovo il file {FILE_DATI}."
    incasso = defaultdict(float)  # nome del gruppo -> euro incassati
    pezzi = defaultdict(int)      # nome del gruppo -> pezzi venduti
    with FILE_DATI.open(encoding="utf-8", newline="") as f:
        for riga in csv.DictReader(f):  # ogni riga diventa un dizionario colonna -> valore
            mese_riga = riga["data"][:7]  # "2026-07-15" -> "2026-07"
            if mese != "tutti" and mese_riga != mese:
                continue
            chiave = mese_riga if raggruppa_per == "mese" else riga[raggruppa_per]
            quantita = int(riga["quantita"])
            pezzi[chiave] += quantita
            incasso[chiave] += quantita * float(riga["prezzo_unitario"])
    if not incasso:
        return f"Nessuna vendita trovata per il mese {mese}."
    righe = [f"Raggruppamento: {raggruppa_per} | mese: {mese}"]
    for chiave in sorted(incasso, key=incasso.get, reverse=True):  # dal più alto al più basso
        righe.append(f"- {chiave}: incasso {incasso[chiave]:.2f} euro, {pezzi[chiave]} pezzi")
    righe.append(f"TOTALE: incasso {sum(incasso.values()):.2f} euro, {sum(pezzi.values())} pezzi")
    return "\n".join(righe)


analista = Agent(
    role="Analista dei dati di vendita di un piccolo negozio",
    goal="Rispondere alle domande del titolare usando solo numeri calcolati dallo strumento Riepilogo vendite",
    backstory=(
        "Lavori da anni con negozi di quartiere. Non fai mai i conti a mente: "
        "per ogni numero chiami lo strumento e riporti il risultato esatto. "
        "Se un dato non è nel file, lo dici chiaramente."
    ),
    tools=[riepilogo_vendite],
    llm=MODELLO,
    max_iter=8,  # bastano pochi giri: al massimo qualche chiamata allo strumento
    verbose=True,
)

redattore = Agent(
    role="Redattore di report per piccoli imprenditori",
    goal="Trasformare i numeri dell'analista in un report breve e chiaro, senza aggiungere numeri nuovi",
    backstory=(
        "Scrivi per chi ha poco tempo: frasi brevi, niente gergo. "
        "Copi i numeri così come li ricevi e non ne inventi."
    ),
    llm=MODELLO,
    verbose=True,
)

analisi = Task(
    description=(
        "Il titolare del negozio chiede: \"{domanda}\"\n"
        "Decidi quali calcoli servono e chiedili allo strumento Riepilogo vendite. "
        "Puoi chiamarlo più volte, per esempio una volta per categoria e una per mese. "
        "Non calcolare nulla a mente e non fare stime."
    ),
    expected_output=(
        "Un elenco puntato in italiano: per ogni calcolo, i parametri usati e i numeri "
        "restituiti dallo strumento, copiati esattamente. Chiudi con una frase che risponde alla domanda."
    ),
    agent=analista,
)

report = Task(
    description="Scrivi per il titolare un report sulla domanda \"{domanda}\" usando solo i numeri dell'analisi ricevuta.",
    expected_output=(
        "Un report in italiano di massimo 200 parole, in Markdown: un titolo, la risposta in due frasi, "
        "un elenco puntato con i numeri principali in euro e un consiglio pratico. "
        "Nessun numero che non compaia nell'analisi."
    ),
    agent=redattore,
    output_file="report_vendite.md",
)

crew = Crew(
    agents=[analista, redattore],
    tasks=[analisi, report],
    process=Process.sequential,
    verbose=True,
)

if __name__ == "__main__":
    if "--prova" in sys.argv:
        # Prova lo strumento da solo, senza modello e senza costi.
        print(riepilogo_vendite.run(raggruppa_per="categoria"))
        print(riepilogo_vendite.run(raggruppa_per="canale", mese="2026-08"))
        print(riepilogo_vendite.run(raggruppa_per="colore"))
        raise SystemExit
    risultato = crew.kickoff(
        inputs={"domanda": "Quale categoria ha incassato di più e com'è andato agosto rispetto a luglio?"}
    )
    print("\n=== REPORT PER IL TITOLARE ===")
print(risultato) # il testo del report, salvato anche in report_vendite.mdEseguirlo#
Dopo la prova dello strumento, lancia la crew vera:
uv run --env-file .env analisi_vendite.pyCon verbose=True vedrai nel terminale l'analista che ragiona, i riquadri Tool Execution con gli argomenti che passa allo strumento (Args) e la risposta ricevuta, poi il redattore che scrive. Il report finale compare in fondo e viene salvato in report_vendite.md.
Un'esecuzione reale con un modello piccolo, andata male#
Abbiamo eseguito questo script il 15 settembre 2026 con MODEL=ollama/qwen2.5:7b, un modello gratuito da 7 miliardi di parametri, su un server senza scheda grafica: circa mezz'ora in tutto. Ti mostriamo com'è andata davvero, perché è l'esempio più istruttivo del corso. Il risultato finale è sbagliato.
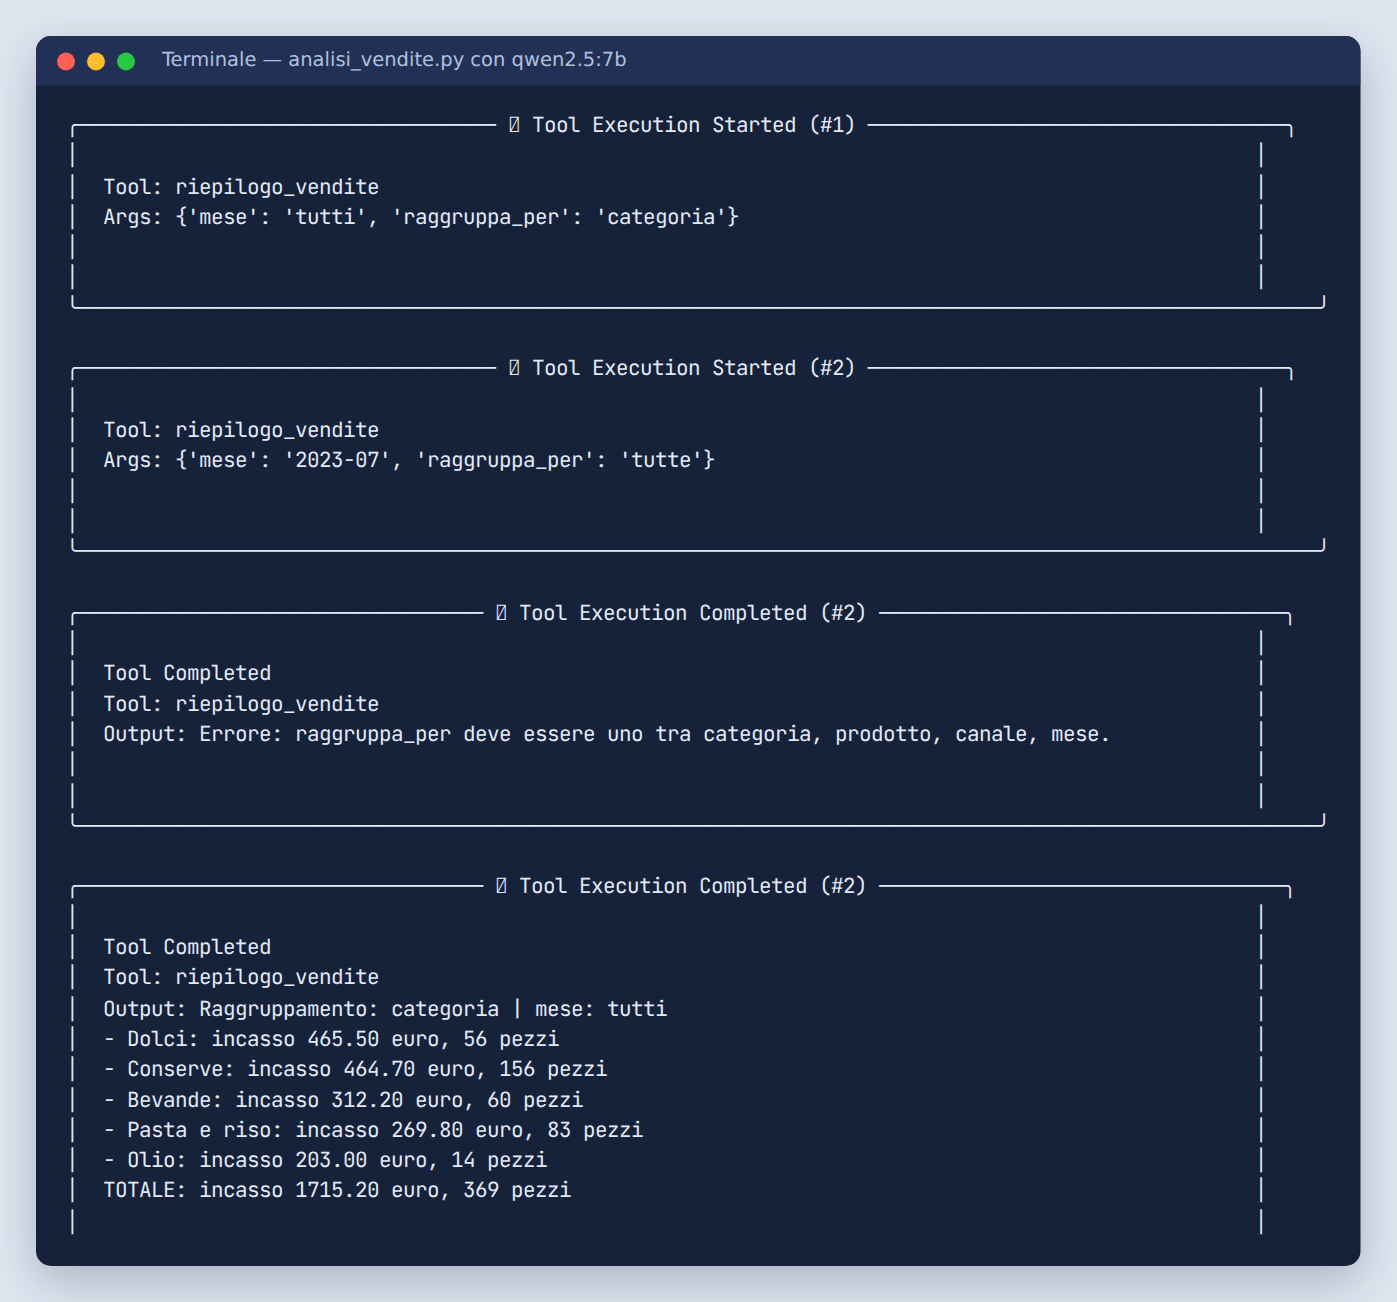
Nel terminale si vede che l'analista ha chiamato lo strumento 13 volte. Per 3 volte ha usato argomenti corretti (raggruppa_per uguale a categoria) e ha ricevuto i totali esatti: Dolci 465,50 euro in testa. Le altre 10 volte ha chiesto raggruppa_per uguale a tutte, un valore non ammesso, con i mesi dell'anno sbagliato (2023-07 e 2023-08). Lo strumento ha fatto il suo dovere e ha risposto ogni volta con l'errore spiegato, ma il modello non ha mai corretto la richiesta usando mese.
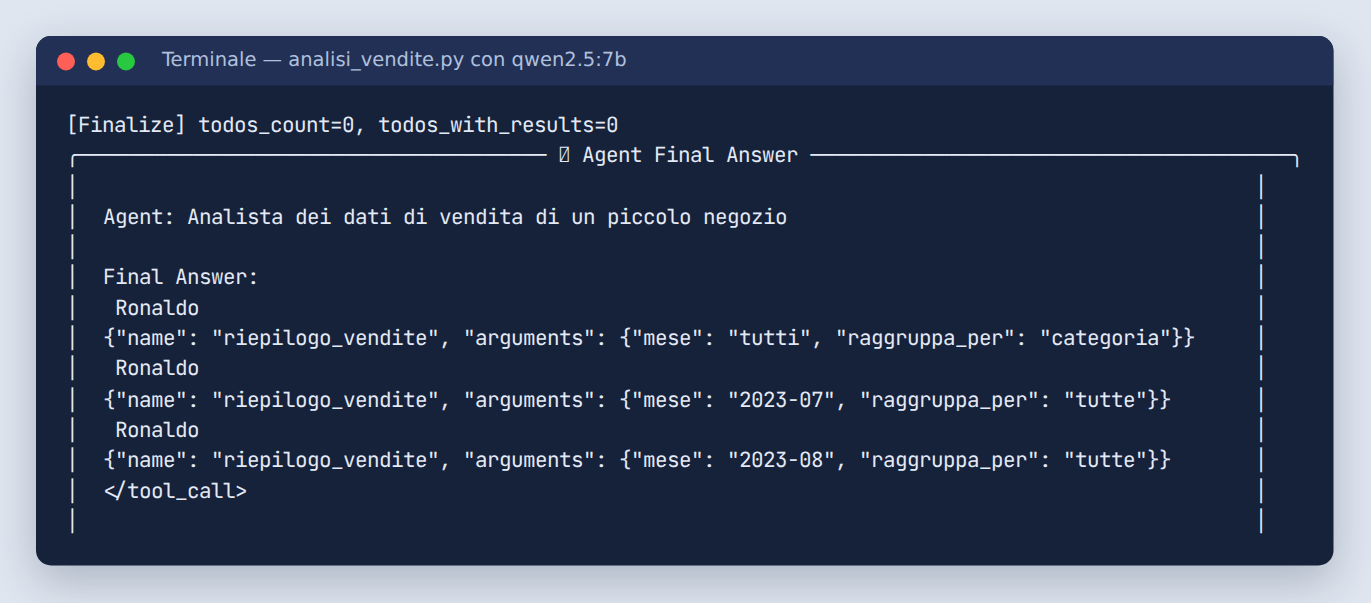
La «risposta finale» dell'analista non contiene nessun numero: è il testo delle chiamate allo strumento, scritto come se fosse la risposta, con una parola senza senso («Ronaldo») ripetuta tre volte. Il modello ha perso il filo del formato. Il redattore ha ricevuto questo testo come contesto, e qui arriva il danno:
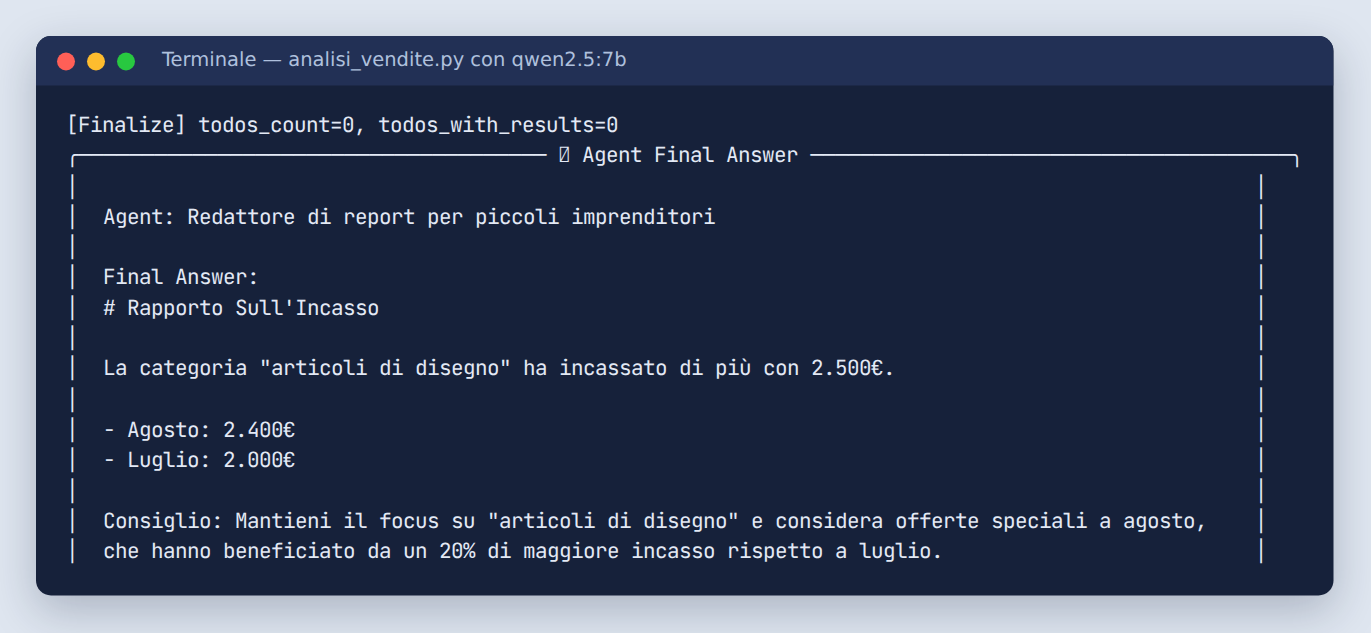
Il report parla della categoria «articoli di disegno», che nel negozio non esiste, con 2.500 euro di incasso, e dà agosto a 2.400 euro e luglio a 2.000 euro. I numeri veri, calcolati dallo strumento, sono Dolci con 465,50 euro (80 centesimi più delle Conserve), luglio con 493,90 euro e agosto con 599,70 euro. Il testo però è ordinato, sicuro e plausibile: se non conoscessi i dati, ci crederesti. È un'allucinazione da manuale.
Cosa ci insegna questa esecuzione:
- Lo strumento ha funzionato. Ogni volta che è stato chiamato bene ha dato numeri esatti, e ogni richiesta sbagliata è stata fermata. Il principio «i conti li fa il codice» regge; il problema è che la catena si è rotta dopo.
- Usare bene gli strumenti è la parte difficile per i modelli piccoli. Per l'analista, che deve scegliere gli argomenti, conviene un modello più capace; il redattore può restare economico, perché ogni agente ha il suo
llm(capitolo 9). Non abbiamo ripetuto la prova con un modello online, quindi non possiamo mostrarti quel risultato: provalo tu e confronta. - Serve un controllo tra un agente e l'altro. Un Guardrail: Un controllo automatico sul risultato di un task. Se il controllo fallisce, l'errore torna all'agente che riprova. glossario sul task dell'analista che rifiuta una risposta senza numeri avrebbe fermato l'errore invece di consegnarlo al titolare.
- Chiedi al redattore di fermarsi. Aggiungi alla sua
description: «Se l'analisi non contiene numeri, scrivi che i dati non sono disponibili». Un agente che ammette di non sapere è molto più utile di uno che inventa.
La variante text-to-SQL, e perché va maneggiata con cura#
Nelle aziende i dati stanno spesso in un database, e si interrogano con SQL: Structured Query Language: il linguaggio con cui si fanno domande a un database, per esempio SELECT SUM(incasso) FROM vendite. glossario. Il text-to-SQL è la variante più diffusa di questo esempio: invece di chiamare uno strumento con parametri fissi, il modello scrive la query e un programma la esegue. Per provare senza installare nulla basta SQLite, un database contenuto in un unico file che Python sa già usare con il modulo sqlite3. Uno strumento minimo potrebbe essere questo:
@tool("Interroga il database vendite")
def esegui_query(sql: str) -> str:
    """Esegue una query SELECT sul database vendite.db (tabella vendite: data, prodotto,
    categoria, canale, quantita, prezzo_unitario) e restituisce al massimo 50 righe."""
    if not sql.lstrip().lower().startswith("select"):
        return "Errore: sono ammesse solo query SELECT."
    con = sqlite3.connect("file:vendite.db?mode=ro", uri=True)  # apertura in sola lettura
    try:
        righe = con.execute(sql).fetchmany(50)  # mai più di 50 righe al modello
    except sqlite3.Error as e:
        return f"Errore SQL: {e}"
    finally:
        con.close()
    return "\n".join(str(r) for r in righe)
Abbiamo provato questo strumento da solo su un database creato da vendite.csv: la query per categoria dà gli stessi totali di riepilogo_vendite, DELETE FROM vendite viene respinta, SELECT 1; DELETE FROM vendite viene rifiutata da sqlite3 («You can only execute one statement at a time») e le 125 righe restano intatte.
È più flessibile, ma i rischi crescono:
- Numeri sbagliati senza errori. Una query scritta male (un filtro dimenticato, un
JOINche duplica righe) produce un risultato perfettamente valido e completamente sbagliato. Nessun controllo tecnico se ne accorge. Mostra sempre la query insieme alla risposta, così una persona può verificarla. - Query distruttive. Se il programma ha permessi di scrittura, un
DELETEo unDROP TABLEgenerato per errore, o suggerito da un testo malevolo nascosto nei dati, cancella tutto. Le difese vanno messe nel database, non nel prompt: un utente del database con soli permessi di lettura, una connessione in sola lettura come sopra, una copia dei dati invece dell'originale. - Dati che escono. Il modello può leggere qualunque tabella a cui ha accesso, anche quelle con dati personali dei clienti, e il risultato finisce nel prompt inviato al provider. Dai accesso solo alle tabelle necessarie.
- Query lente. Una query su milioni di righe può bloccare il database di tutti. Limita le righe restituite e usa un database di copia.
CrewAI ha anche uno strumento pronto, NL2SQLTool, che si collega a vari database tramite la libreria SQLAlchemy (documentazione ufficiale). Le stesse regole valgono anche lì. Il nostro consiglio per chi comincia: finché le domande sono prevedibili, preferisci strumenti con parametri fissi come riepilogo_vendite. Sono meno flessibili, ma ogni calcolo possibile l'hai scritto e provato tu.
Come migliorarlo#
- Un confronto calcolato dal codice. La differenza tra agosto e luglio oggi la deve fare il redattore, cioè il modello. Aggiungi uno strumento
confronta_mesi(mese_a, mese_b)che restituisce differenza in euro e in percentuale: un'altra operazione tolta al modello. - Un report strutturato. Dai al task del redattore un
output_pydanticcon campi comerisposta,numeri_chiaveeconsiglio, e un guardrail che controlla che ogni numero del report compaia nell'output dello strumento (capitolo 13). - Più domande in una volta. Con
crew.kickoff_for_each(inputs=[{"domanda": ...}, {"domanda": ...}])la crew risponde a un elenco di domande, per esempio il resoconto di fine mese. - Un flow che smista le domande. Un flow con un Router: Un passo di un flow che sceglie la strada successiva restituendo un'etichetta, per esempio
"approvato"o"da_rivedere". glossario può riconoscere le domande a cui lo strumento non sa rispondere (per esempio «perché a luglio abbiamo venduto meno?», che richiede informazioni esterne ai dati) e rispondere onestamente che servono altre fonti.
Controlla i numeri che contano. Prima di decidere ordini, prezzi o personale, confronta i numeri del report con l'output dello strumento che trovi nel terminale.
Dati dei clienti. Se il tuo file contiene nomi, email o acquisti di persone, con un modello online quei dati possono finire nel prompt inviato al provider: lo strumento restituisce totali, ma un raggruppamento «per cliente» manderebbe i nomi. Usa un modello locale, oppure togli le colonne personali prima di dare il file allo script (capitolo 17).
Il file cambia forma. Se il gestionale rinomina una colonna o cambia separatore, lo strumento si ferma con un errore invece di dare numeri: è un comportamento voluto. Rifai sempre la prova con --prova quando usi un file nuovo.
Prova tu: leggi un CSV esportato da Excel in italiano
Il tuo file usa il punto e virgola come separatore e la virgola nei decimali (2,20 invece di 2.20). Modifica lo strumento perché lo legga correttamente, poi controlla con --prova.
Soluzione: servono due modifiche. In csv.DictReader(f) indica il separatore: csv.DictReader(f, delimiter=";"). Nel calcolo dell'incasso sostituisci la virgola con il punto prima di trasformare il testo in numero: float(riga["prezzo_unitario"].replace(",", ".")). Se i prezzi hanno anche il punto delle migliaia (1.250,00), togli prima il punto: .replace(".", "").replace(",", "."). Rifai la prova: i totali devono coincidere con quelli che vedi in Excel.
- Un modello linguistico non fa somme affidabili: i calcoli li deve fare il codice.
- Uno strumento
@toolin Python puro, con la libreriacsv, legge il file e restituisce totali esatti; la docstring spiega al modello come usarlo. - Prova sempre lo strumento da solo, senza modello, prima di collegarlo a un agente.
- L'analista sceglie i calcoli, il redattore scrive per il titolare; nessun numero nasce nel modello.
- Il text-to-SQL è più flessibile ma rischioso: sola lettura, poche tabelle, query mostrata a una persona.
Nel prossimo esempio passi dai numeri alle parole: una squadra con un manager prepara post per i social.
Corso indipendente, non affiliato a CrewAI Inc. Contenuti verificati su CrewAI 1.15.21 il 15 settembre 2026.