10 esempi pratici
20Esempio 2 · Domande sui tuoi documenti
Un agente risponde alle domande su un regolamento aziendale usando la knowledge di CrewAI: recupera il passaggio giusto, cita l'articolo e ammette quando la risposta non c'è.
Lumen Srl è una piccola azienda con quaranta dipendenti. L'ufficio del personale riceve ogni settimana le stesse domande: quanti giorni posso lavorare da casa, entro quando va consegnata la nota spese, quanto mi rimborsano il pranzo. Le risposte sono tutte nel regolamento interno, ma nessuno ha voglia di leggerlo.
In questo esempio costruisci un assistente che risponde a quelle domande solo con quello che c'è scritto nel regolamento, indicando l'articolo e copiando la frase da cui prende la regola. È il principio del RAG: Retrieval-Augmented Generation: prima si recuperano i pezzi di documento pertinenti, poi si danno al modello insieme alla domanda. Riduce le allucinazioni sui tuoi dati. glossario: prima si recupera il pezzo di documento giusto, poi si risponde.
Lumen Srl non esiste: l'azienda, le persone e le regole di questo esempio sono inventate per il corso. Usiamo un regolamento finto perché possa essere pubblicato e perché tu possa controllare facilmente se le risposte sono giuste.
- Problema
- Rispondere in modo corretto e verificabile alle domande su un documento interno, senza inventare regole.
- La squadra
- Un solo agente: l'esperto del regolamento.
- Strumenti
- Nessuno strumento: il regolamento arriva all'agente come Knowledge: Documenti tuoi (PDF, testi, CSV…) messi a disposizione degli agenti come fonte da consultare. Ancora le risposte ai tuoi dati. glossario, con
TextFileKnowledgeSource. - Chiavi e costi
- Con Ollama nessuna chiave e nessun costo: servono il modello e un Embedder: Il modello che trasforma un testo in embedding. Per la knowledge CrewAI usa di serie quello di OpenAI; con Ollama puoi usarne uno locale, per esempio
nomic-embed-text. Documenti e domande devono passare dallo stesso embedder. glossario locale. Con OpenAI basta la solita chiave, usata anche per gli embedding. - Cosa impari di nuovo
- Scegliere l'embedder in modo esplicito, dove mettere i file della knowledge, chiedere la citazione del passaggio e far dire all'agente «non lo so».
Perché è tra i più usati#
È il secondo caso della classifica, con 60,4 punti, ed è secondo su entrambi i segnali di GitHub: 822 repository con «crewai rag» nel nome o nella descrizione e il 19,6% delle 562 applicazioni con etichetta crewai (15 settembre 2026). Tra gli esempi ufficiali di CrewAI c'è un assistente che risponde sulle istruzioni di un visore partendo da un PDF, e la guida ufficiale ai casi d'uso cita l'elaborazione di documenti in più fasi. Tra le storie dei clienti, IBM racconta progetti pilota con agenzie federali americane per estrarre e riassumere dati dai documenti.
Il motivo è semplice: ogni organizzazione ha documenti che le persone non leggono. Ed è il modo più diretto per ridurre le Allucinazione: Quando un modello scrive con sicurezza una cosa falsa o inventata. Succede perché il modello genera testo plausibile, non verifica fatti. glossario: il modello non deve ricordare, deve leggere.
Lo schema#
La knowledge lavora in due momenti. Una volta sola, il regolamento viene diviso in Chunk: Un pezzo di documento. Prima di calcolare gli embedding, la knowledge divide i file lunghi in pezzi, così a ogni domanda si recuperano solo le parti utili. glossario, trasformato in Embedding: Una lista di numeri che rappresenta il significato di un testo. Testi con significato simile hanno numeri vicini: così si trovano i pezzi di documento pertinenti a una domanda. glossario e salvato in un Database vettoriale: Archivio specializzato che conserva embedding e trova velocemente quelli più simili a una domanda. CrewAI usa ChromaDB e LanceDB. glossario. A ogni domanda, la domanda passa dallo stesso embedder e si recuperano i pezzi più simili, che l'agente riceve insieme alla richiesta.
Perché un solo agente? La skill ufficiale di CrewAI sul progetto degli agenti dice di partire da uno e aggiungerne altri solo quando servono strumenti, stili o modelli diversi. Qui il lavoro è uno: leggere e rispondere. Un secondo agente «controllore» costerebbe una chiamata in più senza portare informazioni nuove; per controllare la citazione basta del codice, come vedrai nell'esercizio.
Preparazione#
Crea una cartella domande-documenti e dentro una sottocartella che si chiama esattamente knowledge. Scarica il regolamento di esempio e mettilo lì:
- regolamento_lumen.txt: 7 articoli su orario, lavoro da remoto, ferie, malattia, rimborsi, formazione e dispositivi. Contenuto inventato.
Alla fine la cartella è così:
domande-documenti/
├── .env
├── domande_documenti.py
└── knowledge/
    └── regolamento_lumen.txt
Questo esempio funziona bene anche senza chiavi. Se hai seguito il capitolo 7 e hai Ollama: Programma gratuito che scarica ed esegue modelli linguistici sul tuo computer, senza chiavi e senza costi a consumo. glossario acceso, scarica anche il modello che calcola gli embedding (circa 270 MB) e prepara il file .env:
ollama pull nomic-embed-textMODEL=ollama/qwen2.5:7b
CREWAI_DISABLE_TELEMETRY=trueCon OpenAI invece il file .env è quello di sempre, con MODEL=openai/gpt-4.1-mini e OPENAI_API_KEY: la stessa chiave serve anche per gli embedding.
L'embedder è un modello diverso da quello che scrive le risposte. Non genera testo: trasforma ogni pezzo di testo in una lunga lista di numeri che ne rappresenta il significato. Due frasi che parlano della stessa cosa («nota spese» e «rimborso della trasferta») hanno numeri vicini anche se usano parole diverse. Per questo la ricerca trova il passaggio giusto anche se la domanda non ripete le parole del regolamento.
Il codice, pezzo per pezzo#
Le dipendenze#
Rispetto agli altri script c'è una Dipendenza: Un pacchetto di cui il tuo progetto ha bisogno per funzionare. Le dipendenze si elencano in pyproject.toml o in testa allo script. glossario in più, ollama: è il pacchetto Python con cui CrewAI parla con l'embedder locale. Lo abbiamo verificato: senza, CrewAI non si ferma, stampa solo un avviso «Failed to init knowledge» e l'agente risponde senza il regolamento, cioè inventa (lo hai visto nel capitolo 15). Se usi OpenAI non serve, ma non dà fastidio.
# /// script
# requires-python = ">=3.10,<3.14"
# dependencies = ["crewai[tools]==1.15.21", "ollama"]
# ///
Il modello e l'embedder#
Il modello si legge dal file .env come sempre. Poi scegli l'embedder con un if: se il modello è di Ollama usi nomic-embed-text in locale, altrimenti quello di OpenAI. Il formato è un Dizionario: Una raccolta di coppie nome → valore tra parentesi graffe: {"citta": "Arezzo"}. glossario con il provider e la sua configurazione.
MODELLO = os.getenv("MODEL", "openai/gpt-4.1-mini")

if MODELLO.startswith("ollama/"):
    EMBEDDER = {"provider": "ollama", "config": {"model_name": "nomic-embed-text"}}
else:
    EMBEDDER = {"provider": "openai", "config": {"model_name": "text-embedding-3-small"}}
Perché scriverlo anche per OpenAI, che è già il predefinito? Perché così il codice dice chiaramente cosa succede. E soprattutto perché, senza questa riga, uno script con Ollama cercherebbe comunque OpenAI per gli embedding e si fermerebbe per la chiave mancante: è uno degli errori più comuni con la knowledge.
La fonte di knowledge#
CrewAI cerca i file dentro la cartella knowledge/, quindi il percorso si scrive a partire da lì: "regolamento_lumen.txt", non "knowledge/regolamento_lumen.txt". Prima controlliamo che il file ci sia, per darti un messaggio chiaro invece di un errore lungo.
if not os.path.exists("knowledge/regolamento_lumen.txt"):
    sys.exit("Manca il file knowledge/regolamento_lumen.txt: scaricalo come spiegato in Preparazione.")

regolamento = TextFileKnowledgeSource(file_paths=["regolamento_lumen.txt"])L'agente#
La knowledge si attacca all'agente con knowledge_sources, e insieme gli dai l'embedder. La backstory fissa l'atteggiamento che vuoi: niente regole indovinate.
esperto = Agent(
    role="Esperto del regolamento interno di Lumen Srl",
    goal="Rispondere alle domande dei colleghi solo con quello che c'è scritto nel regolamento, citando l'articolo",
    backstory=(
        "Lavori nell'ufficio del personale da dieci anni. Non tiri mai a indovinare: "
        "se una regola non è scritta nel regolamento, lo dici chiaramente."
    ),
    llm=MODELLO,
    knowledge_sources=[regolamento],
    embedder=EMBEDDER,
    verbose=True,
)
Il task#
La descrizione contiene il segnaposto {domanda} e tre regole: usare solo il regolamento, citare articolo e frase, dire «Il regolamento non ne parla» quando serve. L'expected_output fissa un formato a tre righe, facile da leggere e da controllare.
risposta = Task(
    description=(
        "Un collega chiede: \"{domanda}\"\n"
        "Rispondi usando solo il regolamento interno di Lumen Srl che trovi nelle tue conoscenze. "
        "Indica l'articolo da cui prendi la regola e copia parola per parola la frase che la contiene. "
        "Se il regolamento non tratta l'argomento, scrivi: \"Il regolamento non ne parla\" e non inventare nulla."
    ),
    expected_output=(
        "Tre righe in italiano:\n"
        "Risposta: una o due frasi chiare.\n"
        "Fonte: numero e titolo dell'articolo (per esempio: Art. 3 - Ferie).\n"
        "Passaggio: la frase del regolamento copiata tra virgolette."
    ),
    agent=esperto,
    output_file="risposta.md",
)
La crew e la domanda#
La crew ha un agente e un task. Al kickoff passi la domanda.
crew = Crew(
    agents=[esperto],
    tasks=[risposta],
    process=Process.sequential,
    verbose=True,
)

if __name__ == "__main__":
    risultato = crew.kickoff(inputs={"domanda": "Entro quanti giorni devo consegnare la nota spese dopo una trasferta?"})
    print("\n=== RISPOSTA ===")
    print(risultato)  # stampa il testo finale, come risultato.raw
Il codice completo#
# /// script
# requires-python = ">=3.10,<3.14"
# dependencies = ["crewai[tools]==1.15.21", "ollama"]
# ///
"""Risponde alle domande sul regolamento interno (inventato) di Lumen Srl citando l'articolo."""
import os
import sys

from crewai import Agent, Crew, Process, Task
from crewai.knowledge.source.text_file_knowledge_source import TextFileKnowledgeSource

# Il modello si sceglie nel file .env (capitolo 7). Se MODEL manca, si usa quello scritto qui.
MODELLO = os.getenv("MODEL", "openai/gpt-4.1-mini")

# L'embedder trasforma i pezzi del documento in embedding (liste di numeri).
# Con Ollama usiamo un embedder locale; altrimenti quello predefinito di OpenAI.
if MODELLO.startswith("ollama/"):
    EMBEDDER = {"provider": "ollama", "config": {"model_name": "nomic-embed-text"}}
else:
    EMBEDDER = {"provider": "openai", "config": {"model_name": "text-embedding-3-small"}}

# CrewAI cerca i file nella cartella knowledge/: il percorso si scrive a partire da lì.
if not os.path.exists("knowledge/regolamento_lumen.txt"):
    sys.exit("Manca il file knowledge/regolamento_lumen.txt: scaricalo come spiegato in Preparazione.")
regolamento = TextFileKnowledgeSource(file_paths=["regolamento_lumen.txt"])

esperto = Agent(
    role="Esperto del regolamento interno di Lumen Srl",
    goal="Rispondere alle domande dei colleghi solo con quello che c'è scritto nel regolamento, citando l'articolo",
    backstory=(
        "Lavori nell'ufficio del personale da dieci anni. Non tiri mai a indovinare: "
        "se una regola non è scritta nel regolamento, lo dici chiaramente."
    ),
    llm=MODELLO,
    knowledge_sources=[regolamento],
    embedder=EMBEDDER,
    verbose=True,
)

risposta = Task(
    description=(
        "Un collega chiede: \"{domanda}\"\n"
        "Rispondi usando solo il regolamento interno di Lumen Srl che trovi nelle tue conoscenze. "
        "Indica l'articolo da cui prendi la regola e copia parola per parola la frase che la contiene. "
        "Se il regolamento non tratta l'argomento, scrivi: \"Il regolamento non ne parla\" e non inventare nulla."
    ),
    expected_output=(
        "Tre righe in italiano:\n"
        "Risposta: una o due frasi chiare.\n"
        "Fonte: numero e titolo dell'articolo (per esempio: Art. 3 - Ferie).\n"
        "Passaggio: la frase del regolamento copiata tra virgolette."
    ),
    agent=esperto,
    output_file="risposta.md",
)

crew = Crew(
    agents=[esperto],
    tasks=[risposta],
    process=Process.sequential,
    verbose=True,
)

if __name__ == "__main__":
    risultato = crew.kickoff(inputs={"domanda": "Entro quanti giorni devo consegnare la nota spese dopo una trasferta?"})
    print("\n=== RISPOSTA ===")
print(risultato) # stampa il testo finale, come risultato.rawEseguirlo#
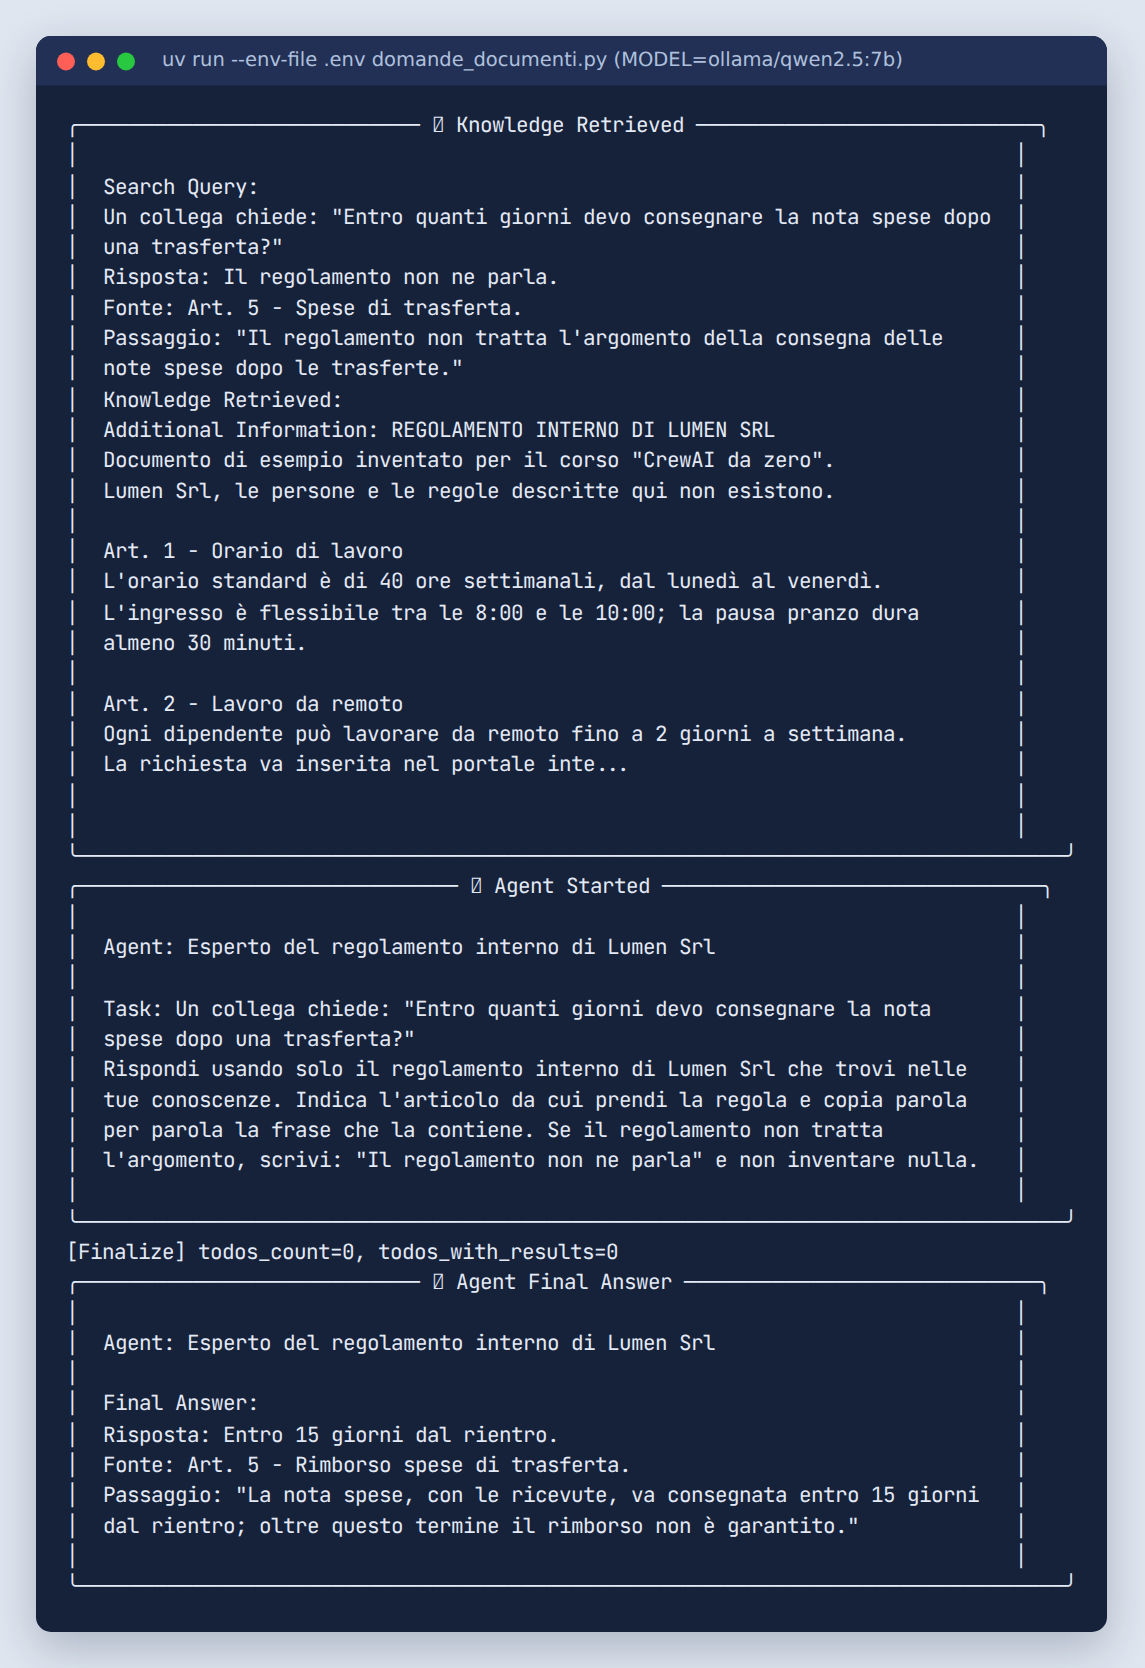
uv run --env-file .env domande_documenti.pyAlla prima esecuzione CrewAI legge il regolamento, calcola gli embedding e li salva nella cartella dei dati di CrewAI del tuo sistema (su Linux sotto ~/.local/share/CrewAI/, su macOS sotto ~/Library/Application Support/CrewAI/, su Windows sotto AppData\Local\CrewAI). Poi l'agente riceve la domanda con i pezzi recuperati e scrive la risposta, che trovi anche in risposta.md.
Funziona se all'inizio del log non compare l'avviso «Failed to init knowledge» e la risposta indica l'Art. 5 con il termine di 15 giorni dal rientro: puoi controllarlo tu nel file del regolamento. La forma esatta della risposta cambia da modello a modello.
Ecco un'esecuzione vera, fatta sul computer del corso con MODEL=ollama/qwen2.5:7b ed embedder nomic-embed-text, senza ritocchi:
Come migliorarlo#
- Un PDF invece del testo. Se il regolamento è un PDF, usa
PDFKnowledgeSource(file_paths=["regolamento.pdf"])dacrewai.knowledge.source.pdf_knowledge_source, sempre con il file nella cartellaknowledge/. Per Word ed Excel esistono sorgenti simili (capitolo 15). - Una risposta in forma di dati. Con
output_pydantice una classe con i campirisposta,articoloepassaggio(capitolo 13) un programma può mostrare la citazione in evidenza, o scartare le risposte senza fonte. - Un controllo della citazione. Un guardrail può verificare che il passaggio citato compaia davvero nel file: è l'esercizio qui sotto.
- Molte domande in fila.
crew.kickoff_for_each(inputs=[{"domanda": "..."}, {"domanda": "..."}])risponde a un elenco di domande. Gli embedding del regolamento sono già salvati, quindi le domande successive partono più in fretta. - Più documenti. Aggiungi altri file alla lista
file_paths, oppure dai la knowledge all'intera crew conCrew(knowledge_sources=[...])se più agenti devono consultarla.
Privacy. Con un provider online, i pezzi del documento vengono inviati ai suoi server due volte: per calcolare gli embedding e dentro il prompt. Per documenti riservati usa Ollama per il modello e per l'embedder, così nulla esce dal computer.
Se cambi embedder, cambia tutto. Embedder diversi producono liste di numeri di lunghezza diversa. Se passi da OpenAI a Ollama (o viceversa) sugli stessi file puoi ricevere un errore di dimensioni degli embedding: la nota ufficiale suggerisce di azzerare la knowledge salvata (in un progetto con crewai reset-memories --knowledge) oppure di usare sempre lo stesso embedder.
Il documento vince, anche quando è vecchio. L'agente risponde con quello che trova. Se il regolamento non è aggiornato, la risposta sarà sbagliata con grande sicurezza. La citazione serve proprio a far controllare a chi legge.
Prova tu: verifica che la citazione sia vera
Scrivi un guardrail che legge il regolamento, prende dalla risposta la riga che inizia con Passaggio: e rifiuta la risposta se quella frase (senza virgolette) non compare nel file. Poi prova una domanda a cui il regolamento non risponde, come «Posso portare il cane in ufficio?».
Soluzione. La funzione lascia passare le risposte che dicono che il regolamento non ne parla, e per le altre cerca il passaggio nel testo del file.
def controlla_citazione(risultato):
    testo = open("knowledge/regolamento_lumen.txt", encoding="utf-8").read()
    if "non ne parla" in risultato.raw:
        return (True, risultato.raw)
    for riga in risultato.raw.splitlines():
        if riga.startswith("Passaggio:"):
            frase = riga.removeprefix("Passaggio:").strip().strip('"«»')
            if frase and frase in testo:
                return (True, risultato.raw)
            return (False, "Il passaggio citato non si trova nel regolamento: copia la frase esatta.")
    return (False, "Manca la riga Passaggio: aggiungi la frase del regolamento tra virgolette.")
Collegala con guardrail=controlla_citazione nel task. Il confronto è severo: basta un apostrofo diverso per fallire. È voluto, perché una citazione «quasi uguale» può cambiare il senso. Con la domanda sul cane, un buon risultato è «Il regolamento non ne parla»; se l'agente inventa una regola, hai trovato il limite del modello che stai usando.
- Le domande sui documenti sono il secondo caso d'uso più diffuso, con 60,4 punti.
- La knowledge divide il file in pezzi, li trasforma in embedding e a ogni domanda recupera solo i pezzi utili.
- I file vanno nella cartella
knowledge/e il percorso si scrive a partire da lì. - Scegli sempre l'embedder: con Ollama serve
nomic-embed-texte il pacchettoollama. - Chiedi articolo e passaggio: una risposta con la citazione si controlla in pochi secondi.
Nel prossimo esempio torni ai flow: una piccola redazione di agenti pianifica, scrive e revisiona un articolo.
Corso indipendente, non affiliato a CrewAI Inc. Contenuti verificati su CrewAI 1.15.21 il 15 settembre 2026.