I mattoni di CrewAI
15Memoria e knowledge
Come un crew ricorda quello che ha fatto (memoria) e come consulta i tuoi documenti (knowledge): embedding, RAG e database vettoriale spiegati con la biblioteca, la configurazione con Ollama, uno script completo e come azzerare tutto.
Finora ogni crew ripartiva da zero: finito il kickoff, gli agenti dimenticavano tutto, e sapevano solo quello che il modello aveva imparato durante l'addestramento. In questo capitolo aggiungi due capacità. La Memoria: La capacità della crew di ricordare informazioni tra un passo e l'altro e tra esecuzioni diverse. Si attiva con memory=True. glossario fa ricordare alla crew quello che ha scoperto e deciso, anche tra un'esecuzione e l'altra. La Knowledge: Documenti tuoi (PDF, testi, CSV…) messi a disposizione degli agenti come fonte da consultare. Ancora le risposte ai tuoi dati. glossario le mette a disposizione i tuoi documenti: un regolamento, un listino, un manuale.
Pensa a un nuovo collaboratore in ufficio. La memoria è il suo taccuino: ci annota quello che succede e lo rilegge prima di un nuovo incarico. La knowledge è la biblioteca aziendale, con un bibliotecario che, a ogni domanda, gli porta solo le schede utili. Senza biblioteca il collaboratore risponderebbe a memoria, e a volte inventerebbe.
Memoria e knowledge: la differenza#
| Memoria | Knowledge | |
|---|---|---|
| A cosa serve | Ricordare quello che la crew ha fatto e scoperto | Consultare documenti che le dai tu |
| Da dove arriva il contenuto | Dai risultati dei task e da quello che salvi con remember | Da testi, PDF, CSV, JSON, fogli Excel |
| Quando si usa | Crew che devono migliorare o riprendere un lavoro | Agenti che devono rispondere sui tuoi dati |
| Come si attiva | memory=True sulla crew | knowledge_sources=[...] su crew o agente |
Le due funzioni hanno un motore in comune: il modo in cui si trovano le informazioni giuste in mezzo a tante. Conviene capirlo prima di scrivere codice.
Come si trovano le cose: la biblioteca#
Un modello non può leggere un manuale di 300 pagine a ogni domanda: la sua Finestra di contesto: Quanti token un modello riesce a considerare tutti insieme in una volta (prompt + risposta). Oltre quel limite, il testo più vecchio va tagliato o riassunto. glossario è limitata e ogni Token: Il pezzetto di testo con cui ragiona un modello: una parola corta, un pezzo di parola o un segno di punteggiatura. Secondo le stime di OpenAI, in inglese un token vale in media circa ¾ di parola. I servizi a pagamento contano (e fanno pagare) i token. glossario in più costa tempo e denaro. Serve un bibliotecario che scelga i pezzi giusti. Ecco come lavora.
- Taglia i documenti a schede. Ogni documento viene diviso in brani corti, i Chunk: Un pezzo di documento. Prima di calcolare gli embedding, la knowledge divide i file lunghi in pezzi, così a ogni domanda si recuperano solo le parti utili. glossario.
- Dà a ogni scheda una posizione sulla mappa dei significati. Un modello speciale, l'Embedder: Il modello che trasforma un testo in embedding. Per la knowledge CrewAI usa di serie quello di OpenAI; con Ollama puoi usarne uno locale, per esempio
nomic-embed-text. Documenti e domande devono passare dallo stesso embedder. glossario, trasforma ogni brano in un Embedding: Una lista di numeri che rappresenta il significato di un testo. Testi con significato simile hanno numeri vicini: così si trovano i pezzi di documento pertinenti a una domanda. glossario: una lunga lista di numeri che rappresenta il significato. Due brani che parlano della stessa cosa, anche con parole diverse, ricevono numeri vicini. «Posso portare un amico?» e «Regole per gli ospiti» finiscono vicini sulla mappa, anche se non hanno parole in comune. - Mette le schede nello schedario. Gli embedding si salvano in un Database vettoriale: Archivio specializzato che conserva embedding e trova velocemente quelli più simili a una domanda. CrewAI usa ChromaDB e LanceDB. glossario, un archivio fatto apposta per trovare in fretta i numeri più vicini a quelli di una domanda. CrewAI usa ChromaDB per la knowledge e LanceDB per la memoria.
- A ogni domanda cerca le schede più vicine. Anche la domanda diventa un embedding, con lo stesso embedder; il database restituisce i brani più simili. Per la knowledge collegata alla crew, CrewAI 1.15.21 ne prende al massimo 3 e scarta quelli con punteggio di somiglianza sotto 0,35; per quella collegata a un singolo agente i valori predefiniti sono 5 e 0,6. Si cambiano con i parametri
results_limitescore_thresholddiKnowledgeConfig. - Il modello risponde con le schede in mano. I brani trovati vengono aggiunti al prompt insieme alla domanda.
Questo metodo, prima recuperare e poi generare, si chiama RAG: Retrieval-Augmented Generation: prima si recuperano i pezzi di documento pertinenti, poi si danno al modello insieme alla domanda. Riduce le allucinazioni sui tuoi dati. glossario. Riduce le Allucinazione: Quando un modello scrive con sicurezza una cosa falsa o inventata. Succede perché il modello genera testo plausibile, non verifica fatti. glossario perché il modello non deve ricordare: deve leggere.
Un embedding è come le coordinate di una città su una cartina, solo con centinaia di numeri invece di due. Non devi mai leggerli né calcolarli tu: li produce l'embedder. Ti basta sapere due cose. Primo: domanda e documenti devono passare dallo stesso embedder, altrimenti è come confrontare coordinate di cartine diverse. Secondo: anche l'embedder è un modello, quindi o gira sul tuo computer o è un servizio online.
La memoria#
Nelle versioni recenti di CrewAI, compresa la 1.15.21, la memoria è una sola classe, Memory. I tutorial più vecchi parlano di memoria «a breve termine», «a lungo termine» e «delle entità»: quelle tre memorie separate sono state sostituite da questa. Il modo più semplice per usarla è accenderla sulla crew:
crew = Crew(
    agents=[ricercatore, scrittore],
    tasks=[ricerca, guida],
    memory=True,   # la crew ricorda tra un task e l'altro e tra un'esecuzione e l'altra
)
Con memory=True, dopo ogni task la crew estrae dal risultato dei fatti brevi e li salva; prima di ogni task l'agente cerca nella memoria quello che serve e lo aggiunge al prompt. Tutti gli agenti condividono la memoria della crew.
La memoria si può usare anche da sola, senza agenti, con due Metodo: Un'azione che un oggetto sa fare, chiamata con il punto e le parentesi: crew.kickoff() chiede all'oggetto crew di partire. glossario: remember per salvare e recall per cercare. Questo esempio è della documentazione ufficiale, con i testi tradotti:
from crewai import Memory

memoria = Memory()
# Salva: un modello decide da solo argomento, categorie e importanza
memoria.remember("Abbiamo deciso di usare PostgreSQL per il database degli utenti.")
# Cerca: i risultati sono ordinati per somiglianza, data e importanza
for ricordo in memoria.recall("Quale database abbiamo scelto?"):
    print(f"[{ricordo.score:.2f}] {ricordo.record.content}")
Ogni risultato ha un punteggio (score) e il testo salvato (record.content). Quando i ricordi diventano tanti, si possono organizzare in «scope», percorsi come /cliente/rossi, e dare a un agente una memoria privata con memory=memoria.scope("/agent/ricercatore").
Dove salva e cosa usa#
- Dove: in un database LanceDB nella cartella
./.crewai/memory, dentro la cartella da cui lanci lo script. Puoi cambiarla con la Variabile d'ambiente: Un valore con un nome (per esempioOPENAI_API_KEY) che i programmi leggono dal sistema invece che dal codice. Serve a tenere i segreti fuori dai file di codice. glossarioCREWAI_STORAGE_DIRo conMemory(storage="percorso"). Dal terminale,crewai memoryapre un programma per sfogliare i ricordi. - Quale modello: la memoria usa un LLM: Large Language Model, grande modello linguistico: un programma addestrato su enormi quantità di testo che, data una frase, prevede le parole che seguono. È il motore di ChatGPT, Claude, Gemini. glossario per analizzare quello che salva e le domande. La documentazione dice che di default è
gpt-4o-minidi OpenAI; nel codice di CrewAI 1.15.21 il valore predefinito è invecegpt-5.4-mini, sempre di OpenAI. - Quale embedder: di default OpenAI
text-embedding-3-large.
Quindi, se non configuri niente, la memoria ha bisogno di una chiave OpenAI, anche se i tuoi agenti usano Ollama. Per lavorare tutto in locale, passa alla crew una memoria configurata:
from crewai import Memory

memoria_locale = Memory(
    llm="ollama/qwen2.5:3b",                                                # il modello che analizza
    embedder={"provider": "ollama", "config": {"model_name": "nomic-embed-text"}},  # l'embedder locale
)

crew = Crew(agents=[ricercatore], tasks=[ricerca], memory=memoria_locale)
Prima di usarlo, scarica l'embedder in Ollama: Programma gratuito che scarica ed esegue modelli linguistici sul tuo computer, senza chiavi e senza costi a consumo. glossario con ollama pull nomic-embed-text e aggiungi il pacchetto Python ollama alle dipendenze (lo vedi nello script completo più avanti).
Nella configurazione dell'embedder scrivi "model_name", non "model" come negli esempi della documentazione. L'abbiamo provato con CrewAI 1.15.21: con "model" il nome dell'embedder va perso. Con Ollama CrewAI usa al suo posto la variabile MODEL del file .env, cioè il modello che scrive (per esempio ollama/qwen2.5:7b), e mentre legge i documenti si ferma con l'errore «model not found». Con OpenAI non dà errori ma usa un altro embedder, text-embedding-3-large, che costa di più.
La documentazione avverte che il contenuto della memoria viene inviato al modello configurato per l'analisi. Se salvi dati personali o riservati e usi un modello online, quei dati escono dal tuo computer. Per dati sensibili la documentazione consiglia un Modello locale: Un modello che gira sul tuo computer invece che sui server di un'azienda. Privacy e costo zero, ma di solito più lento e meno capace. glossario come Ollama, sia per l'LLM sia per l'embedder.
La knowledge#
Una fonte di knowledge è un oggetto che dice a CrewAI dove prendere il testo. Le più usate:
| Fonte | Import | Per |
|---|---|---|
StringKnowledgeSource(content="...") | crewai.knowledge.source.string_knowledge_source | Un testo scritto nel codice |
TextFileKnowledgeSource(file_paths=[...]) | crewai.knowledge.source.text_file_knowledge_source | File .txt |
PDFKnowledgeSource(file_paths=[...]) | crewai.knowledge.source.pdf_knowledge_source | File PDF (usa il pacchetto pdfplumber, che si installa già insieme a crewai) |
CSVKnowledgeSource, ExcelKnowledgeSource, JSONKnowledgeSource | moduli con lo stesso schema di nome | Tabelle e dati strutturati |
Tre regole pratiche:
- I file vanno nella cartella
knowledge, accanto allo script o alla radice del progetto, e i percorsi si scrivono a partire da quella cartella:file_paths=["regolamento.txt"], non"knowledge/regolamento.txt". Se sbagli, l'errore è «file non trovato». - Crew o agente.
Crew(knowledge_sources=[...])rende i documenti disponibili a tutti gli agenti;Agent(knowledge_sources=[...])solo a quell'agente. Le due cose si possono combinare: ognuna finisce in una raccolta separata dello stesso database. - L'embedder predefinito è OpenAI (
text-embedding-3-small, diverso da quello della memoria). Con Ollama devi indicarlo con il parametroembedder, sulla crew o sull'agente.
La knowledge viene salvata fuori dalla cartella dello script: in ~/.local/share/CrewAI/<progetto>/knowledge/ su Linux, ~/Library/Application Support/CrewAI/<progetto>/knowledge/ su macOS e C:\Users\<utente>\AppData\Local\CrewAI\<progetto>\knowledge\ su Windows.
Lo script completo: la reception della palestra#
Una palestra (inventata, come le sue regole) vuole un assistente che risponda ai soci leggendo il regolamento. Lo script crea da solo il file del regolamento nella cartella knowledge se non esiste, lo collega alla crew come knowledge e fa una domanda la cui risposta si trova solo nel documento. Se MODEL è un modello Ollama usa l'embedder locale, altrimenti quello di OpenAI.
# /// script
# requires-python = ">=3.10,<3.14"
# dependencies = ["crewai[tools]==1.15.21", "ollama"]
# ///
"""Un agente risponde alle domande dei soci usando il regolamento della palestra (knowledge)."""
import os
from pathlib import Path

from crewai import Agent, Crew, Process, Task
from crewai.knowledge.source.text_file_knowledge_source import TextFileKnowledgeSource

# Il modello si sceglie nel file .env (capitolo 7). Se MODEL manca, si usa quello scritto qui.
MODELLO = os.getenv("MODEL", "openai/gpt-4.1-mini")

# L'embedder trasforma i pezzi di testo in numeri (embedding).
# Con Ollama tutto resta sul tuo computer: prima serve "ollama pull nomic-embed-text"
# e il pacchetto Python "ollama" (è nelle dipendenze qui sopra).
# Con OpenAI si usa la stessa chiave del modello.
if MODELLO.startswith("ollama/"):
    EMBEDDER = {"provider": "ollama", "config": {"model_name": "nomic-embed-text"}}
else:
    EMBEDDER = {"provider": "openai", "config": {"model_name": "text-embedding-3-small"}}

# Il documento di esempio: una palestra inventata, con regole inventate.
REGOLAMENTO = """Regolamento della Palestra Aurora (palestra immaginaria, dati di esempio)

Art. 1 - Orari. Dal lunedì al venerdì la palestra è aperta dalle 7:00 alle 22:00.
Il sabato dalle 9:00 alle 18:00. La domenica è chiusa.

Art. 2 - Abbonamenti. Mensile 45 euro, trimestrale 120 euro, annuale 400 euro.
L'iscrizione costa 20 euro una volta sola e comprende l'assicurazione.

Art. 3 - Ospiti. Chi ha l'abbonamento annuale può portare un ospite al massimo
due volte al mese. L'ingresso dell'ospite costa 8 euro e va pagato alla reception.
Con gli abbonamenti mensile e trimestrale gli ospiti non sono ammessi.

Art. 4 - Sospensione. L'abbonamento annuale si può sospendere una volta sola,
per un massimo di 30 giorni, presentando un certificato medico.

Art. 5 - Armadietti. Gli armadietti vanno liberati ogni sera. Il lucchetto è personale.
Alle 22:15 il personale apre gli armadietti rimasti chiusi.
"""

# I file della knowledge vanno nella cartella "knowledge", accanto allo script.
cartella = Path("knowledge")
cartella.mkdir(exist_ok=True)
documento = cartella / "regolamento_palestra.txt"
if not documento.exists():
    documento.write_text(REGOLAMENTO, encoding="utf-8")

# Il percorso si scrive a partire dalla cartella knowledge, non dalla cartella dello script.
regolamento = TextFileKnowledgeSource(file_paths=["regolamento_palestra.txt"])

addetto = Agent(
    role="Addetto alla reception della Palestra Aurora",
    goal="Rispondere alle domande dei soci citando il regolamento",
    backstory=(
        "Lavori alla reception da anni. Rispondi solo con quello che c'è scritto nel "
        "regolamento e, se un'informazione manca, lo dici con onestà."
    ),
    llm=MODELLO,
    verbose=True,
)

risposta = Task(
    description="Un socio chiede: {domanda}. Rispondi usando il regolamento della palestra.",
    expected_output=(
        "Una risposta di 2-4 frasi in italiano che indica il numero dell'articolo usato. "
        "Se il regolamento non dice nulla, scrivilo."
    ),
    agent=addetto,
)

crew = Crew(
    agents=[addetto],
    tasks=[risposta],
    process=Process.sequential,
    knowledge_sources=[regolamento],  # la knowledge, condivisa da tutta la crew
    embedder=EMBEDDER,                # chi calcola gli embedding
    verbose=True,
)

if __name__ == "__main__":
    domanda = "Ho l'abbonamento trimestrale: posso portare mia sorella e quanto paga?"
    risultato = crew.kickoff(inputs={"domanda": domanda})
    print("\n=== RISPOSTA ===")
    print(risultato.raw)
Rispetto al primo crew ci sono tre novità: la preparazione del file, la fonte TextFileKnowledgeSource e i due parametri della crew knowledge_sources ed embedder. La domanda è scelta apposta: la risposta giusta («no, con il trimestrale gli ospiti non sono ammessi», articolo 3) si trova solo nel regolamento, quindi un modello che non lo legge non può indovinarla.
Eseguirlo#
Con Ollama, scarica prima l'embedder (una volta sola, circa 270 MB) e poi lancia lo script con il file .env del capitolo 7, in cui MODEL è per esempio ollama/qwen2.5:7b:
ollama pull nomic-embed-text
uv run --env-file .env reception_palestra.py
Alla prima esecuzione CrewAI legge il regolamento, lo taglia in pezzi e ne calcola gli embedding; poi l'agente cerca i pezzi pertinenti alla domanda e risponde. Nel terminale vedi i soliti riquadri di verbose e, in fondo, la risposta.
Un errore istruttivo: la knowledge che non si carica#
La prima volta che abbiamo eseguito lo script, con CrewAI 1.15.21 e il modello qwen2.5:7b, nelle dipendenze mancava il pacchetto ollama. CrewAI non si è fermato: ha stampato un avviso in giallo all'inizio e ha fatto rispondere l'agente lo stesso. Questo è l'avviso, copiato dal log:
[WARNING]: Failed to init knowledge: 1 validation error for KnowledgeStorage
  Value error, The ollama python package is not installed. Please install it with `pip install ollama`
E questa è la risposta che è arrivata:
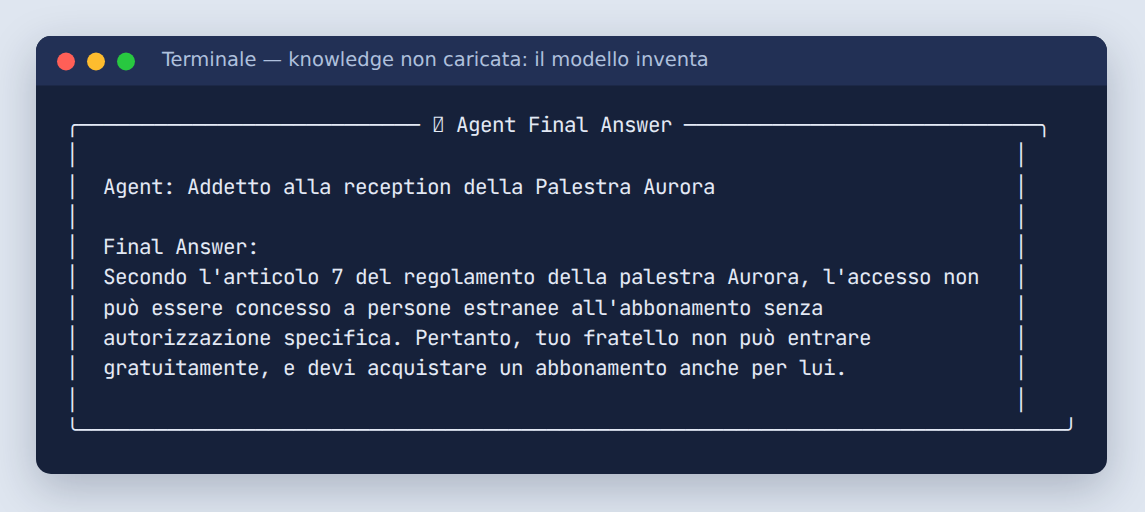
Guardala bene: cita un «articolo 7» che non esiste (il regolamento ne ha 5), parla di un fratello mentre la domanda era sulla sorella, e dice di comprare un abbonamento invece di dire che gli ospiti non sono ammessi. È un'allucinazione da manuale, scritta con tono sicuro. Due lezioni: leggi sempre gli avvisi WARNING all'inizio del log, e prova la knowledge con una domanda di cui conosci la risposta. Nello script completo il pacchetto ollama è già nelle dipendenze; con OpenAI non serve.
La knowledge funziona se nel log non c'è l'avviso «Failed to init knowledge» e la risposta cita l'articolo 3 dicendo che con il trimestrale gli ospiti non sono ammessi. Con un modello piccolo la forma della risposta può variare: conta che il contenuto venga dal regolamento.
Azzerare memoria e knowledge#
Memoria e knowledge restano salvate tra un'esecuzione e l'altra. A volte vuoi ripartire pulito: hai cambiato embedder (e compare un errore sulle dimensioni degli embedding), hai fatto prove sbagliate, o vuoi rileggere documenti modificati. In un progetto creato con crewai create, dalla sua cartella, usa la CLI: Command Line Interface: un programma che si usa dal terminale con comandi. CrewAI ne ha una: crewai create, crewai run… glossario:
crewai reset-memories -m     # solo la memoria
crewai reset-memories -kn    # la knowledge della crew
crewai reset-memories -akn   # la knowledge dei singoli agenti
crewai reset-memories -k     # gli ultimi risultati dei task salvati dal kickoff
crewai reset-memories -a # tutto insiemeLa pagina della documentazione sulla CLI elenca ancora le opzioni -l (long), -s (short) ed -e (entities), che appartengono alle vecchie memorie separate. In CrewAI 1.15.21 non esistono più: crewai reset-memories --help mostra solo -m, -kn, -akn, -k e -a. Il comando cancella i dati senza chiedere conferma.
Con uno script singolo, fuori da un progetto, puoi chiamare dal codice crew.reset_memories(command_type="memory") (oppure "knowledge") o cancellare a mano la cartella .crewai/memory.
Prova tu: una knowledge solo per un agente
Aggiungi alla palestra un secondo documento breve, scritto direttamente nel codice, con le promozioni del mese («A settembre l'iscrizione è gratuita per chi sottoscrive l'annuale»). Deve vederlo solo l'addetto, non tutta la crew. Poi chiedi: «Quanto pago di iscrizione se faccio l'annuale a settembre?».
Soluzione. Usa StringKnowledgeSource e passala all'agente con il suo embedder:
from crewai.knowledge.source.string_knowledge_source import StringKnowledgeSource

promozioni = StringKnowledgeSource(
    content="Promozioni di settembre (dati di esempio): l'iscrizione è gratuita per chi sottoscrive l'abbonamento annuale."
)

addetto = Agent(
    role="Addetto alla reception della Palestra Aurora",
    goal="Rispondere alle domande dei soci citando il regolamento",
    backstory="Lavori alla reception da anni e non inventi nulla.",
    llm=MODELLO,
    knowledge_sources=[promozioni],  # solo per questo agente
    embedder=EMBEDDER,
)
Il regolamento resta sulla crew. La risposta attesa combina le due fonti: normalmente l'iscrizione costa 20 euro (articolo 2), ma a settembre con l'annuale è gratuita.
- La memoria ricorda quello che la crew fa (
memory=True, oppureMemoryconremembererecall); la knowledge dà agli agenti i tuoi documenti (knowledge_sources). - Entrambe usano il RAG: documenti a pezzi, embedding, database vettoriale, ricerca dei pezzi più vicini alla domanda.
- Di default memoria e knowledge usano OpenAI. Con Ollama configura
embedder(e il modello della memoria), scaricanomic-embed-texte aggiungi il pacchettoollama. - I file della knowledge vanno nella cartella
knowledge, con percorsi relativi a quella cartella. - Leggi gli avvisi: se la knowledge non si carica, l'agente risponde lo stesso e inventa.
- Per ripartire da zero:
crewai reset-memoriescon-m,-kn,-akn,-ko-a.
Nel prossimo capitolo passi dalla squadra al copione: i flow, che mettono in fila passi, controlli e crew con uno stato condiviso.
Corso indipendente, non affiliato a CrewAI Inc. Contenuti verificati su CrewAI 1.15.21 il 15 settembre 2026.